
· engineering· 约 25 分钟精读
Csv Export Escape Set Reader Type Guessing Offline Ledger — Technical Analysis | KeyRotate Technology
两款产品的 CSV 导出共用同一套三字符转义判定,而解析器认三种行边界、桌面表格软件按自己的规则补类型。本文按源码分支与逐行转写的复算,把一份离线台账从写出字节到被读成什么,逐格核对清楚。
现场检验做完,台账要以文件的形式交给甲方、评审方或者归档系统。端侧离线的工具在这一点上没有例外:数据不出设备说的是采集与存储阶段,导出那一步本身就是外发。TagWorks 与 SlingGuard 都把 CSV 作为可选载体之一,理由很直接——对方能用表格软件直接打开。而”直接打开”这四个字,正是这一段路上所有分歧的来源。
本文不做抽象讨论,只回答三个问题:写出时哪些字符会被处理,读回时哪些字符会被当成结构,中间那一层桌面软件会替你做哪些你没要求它做的判断。
一、规范只管字符,不管含义
RFC 4180 对 CSV 的定义只有四条硬约束:记录以 CRLF 结束,字段以逗号分隔,字段可以选择性地用双引号包裹,一旦包裹则字段内部的双引号必须写成两个。规范同时明确列出只有逗号、双引号、CR、LF 这四个字符需要在引用时被考虑,并且明确把数据类型排除在讨论范围之外。
也就是说,一份 CSV 文件里不存在”这一列是数值""这一列是日期""这一格是文本编号”这样的声明。写方能给出的全部信息,就是一串带分隔符的字节;语义由读方补,而读方怎么补,规范没有约束。
左右滑动查看完整图表
二、写出侧:一个字段值只被问三个问题
两款产品的四个导出函数(TagWorks 的登记册与测试历史,SlingGuard 的资产册与检验证据)共用同一段转义逻辑:字段中出现逗号、双引号或换行符时,用引号把整格包起来,内部引号双写;其余情况原样写出。四处代码的判定集完全一致。
按这个判定集,真正会触发包裹的字段比表面看上去多。举一个不是假设的例子:SlingGuard 的色标枚举把额定值写进了字符串本身,形如 Violet (1t / 2,200 lbs) 的 rawValue 同时是界面文案、JSON 存储值和 CSV 单元格内容,八个取值的英文写法全部带千位逗号。于是 Color Code 这一列只要非空,导出时每一行都会被包上引号,且格子里始终留着一个真实的逗号。
四份文件的字符约定可以并排看:
| 导出文件 | 列数 | 行尾 | 编码 | 日期写法 |
|---|---|---|---|---|
| TagWorks 登记册 | 26 | 仅 LF | UTF-8 无 BOM | yyyy-MM-dd,随系统区域 |
| TagWorks 测试历史 | 26 | 仅 LF | UTF-8 无 BOM | ISO 8601,UTC 带毫秒 |
| SlingGuard 资产册 | 19 | 仅 LF | UTF-8 无 BOM | ISO 8601,UTC |
| SlingGuard 检验证据 | 31 | 仅 LF | UTF-8 无 BOM | ISO 8601,UTC |
有两处偏离标准值得单独记下来。其一是行尾:标准要求 CRLF,实现统一用单个 LF。主流表格软件与多数解析库都接受 LF,但”多数接受”与”符合规范”不是同一件事。其二是判定集里没有 CR:一个只含 CR 而不含 LF 的字段,会被判为”不需要包裹”,原样写出去。第二处的后果要到读回侧才看得见。
三、读回侧:行边界的字符集比写出侧多一个
两款产品的解析器都把 CR、LF、CRLF 三种写法认作行结束。TagWorks 遇到 CR 时前瞻一位,若是 LF 就一起吃掉,否则就地收尾;SlingGuard 写法不同,效果一致。而写出侧从不为 CR 加引号。两套词表放在一起,就得到一个可以复算的结论:本应用写出的文件,本应用读不回来。
scripts/csv_roundtrip_probe.py 按上述函数逐行转写后运行。取一条备注为 Handle cracked 加一个裸 CR 加 replace 的记录,写出的是:
Kettle,TST-002,Break Room,classI,Handle cracked<CR>replace再喂回 TagWorks 的解析器,得到 3 行而不是 2 行:表头一行、Kettle 一行,剩下的 replace 自成一格落在首列。由于”名称”在导入侧是必填列、首列正是名称列,这条尾巴会被当成一台新设备入库;它的标识列为空,导入器还会自动补一个 IMP- 开头的流水号。一条备注里的回车,在回读时变成一台不存在的设备,并且占掉一个额度位。
引号的位置规则也有类似的对不齐。两套解析器进入引用态的条件都是”看见一个双引号”,并不要求它出现在字段开头——TagWorks 是无条件置位,SlingGuard 是直接翻转标志。对自家写出的文件这没问题,因为内部引号一定被双写过;对第三方生成的行就不是了。复算里给一行 Webbing 2" wide,SL-9,Depot(把两英寸写成双撇号,是索具台账里非常自然的写法),两套解析器都把它塌成一个字段,整行的逗号连同后续列一起进了”当前字段”,直到文本结束也没等到闭合引号。
两款解析器对空行的口径也不一致:SlingGuard 在追加记录前检查整行是否全为空白并直接丢弃,TagWorks 把它收进结果集、再在循环里跳过且不计入跳过数。同一份文件,TagWorks 报出的总行数与”入库加跳过”之和会差出一个空行的数目,而差额不属于任何一类可以解释的错误标签。
四、类型由读方补:数字、日期与小数位
字段落盘时是字符串,被表格软件打开时会被重新猜成别的类型。Microsoft 在自己那篇功能说明里逐项列出了这些默认转换:从数字文本中去掉前导零并转为数值、把数值截断到 15 位有效数字并按需转科学计数、把字母 E 前后的数字转成科学计数、把连续的字母与数字串转成日期。较新版本的 Excel 允许按类关闭(Windows 2309 起、Mac 16.77 起提供开关),但默认全部开着。
把现场台账里会出现的几类字面放进这张表,破坏面就很具体:
| 落盘字面 | 为什么会写成这样 | 表格软件默认读成 |
|---|---|---|
0042 | 现场编号习惯补零 | 数值 42,前导零不可恢复 |
1234567890123456 | 长序列号纯数字 | 截到 15 位,末位归 0 |
100.0 | Double 直接转字符串 | 数值 100,小数位消失 |
2026-01-02 | 登记册的日期列 | 日期序列,显示格式随系统区域改写 |
名称列里的 1-2 | 楼层、跨线、区段的普通写法 | 被转成日期 |
nan / inf | 读数落库后,导出层没有有限性闸门 | 各家不一,多为错误值或文本 |
最后一行是本项目自己的问题,不是桌面软件的问题。TagWorks 的读数在落库前只经过一次 Double(text),判定层的 TestThresholds.evaluate 确实对有限性做了检查,非有限值一律判失败,这一点在单元测试里被钉住;但导出层没有复用同一道闸门,earthContinuityMilliohms.map { String($0) } 会把一个非有限值直译成 nan 写进 CSV。判定链认识的特殊值,和交付文件里出现的特殊值,不是同一套口径。
日期还有一处写法差异。TagWorks 的登记册用的是裸 DateFormatter:代码里设了 dateFormat,没设 locale,也没设 calendar 和 timeZone。Apple 对这种用法有明确说明——设定格式串时 DateFormatter 仍会代入用户的区域与偏好,包括在系统设置里改选的历法,因此固定格式应当显式指定 POSIX locale 与 UTC;它在文档里给的例子正是佛历:同一个 2010 会被解释成另一种历法下的另一个年份。反过来说,在这样的设备设置下,yyyy 写出去的就是佛历年份,而文件里没有任何一处标明用的是哪种历法。SlingGuard 的 CSV 路径全程用 ISO8601DateFormatter,不参与这件事。同一套台账体系里,两份产品的日期落盘可靠性并不等价。
五、编码:写侧都不写 BOM,读侧修的不是同一半
写侧两款一致:都是把字符串按 UTF-8 编码成 Data 交出去,不写 BOM。读侧两款差得很远。TagWorks 提供文件通道,可选类型是逗号分隔文本与纯文本,读入前显式剥掉 U+FEFF,解码方式是硬指定 UTF-8,失败即弹一句”读不了这个 CSV”,没有编码嗅探也没有降级路径。SlingGuard 的 CSV 导入页只有一个粘贴框和一个”载入标准模板”按钮,没有文件通道(它的文件选择器挂在设置页的备份恢复上,允许的类型是 JSON 与 Data)。它的表头归一只做首尾空白清理加小写化,而 U+FEFF 不在被清理的字符集里——于是任何带着 BOM 进来的文本,首列 Tag ID 都匹配不上,返回的是”表头必须包含 Tag ID、设备名、类型与 WLL”这样一句归因错误的整批拒收:那四列在文件里其实全都在。
无 BOM 的 UTF-8 交给 Windows 上的表格软件时,默认解码跟随系统 ANSI 码页,中文设备名与位置名会被按另一种码页解释,画面就是乱码。用户看到乱码后在表格软件里手工调整、另存——多半存成系统默认码页,或者带 BOM 的 UTF-8——再拿回来导入:带 BOM 的那份 TagWorks 能剥掉读进去,非 UTF-8 的那份直接抛错,一条都进不去。台阶在”读”这一侧修了一半,“写”这一侧完全没修,而两款修的还不是同一半。
粘贴这条通道值得单独说一句:它把桌面软件的猜测固化成台账内容。从表格软件里复制一列——被去掉前导零的编号、被换算成日期的区段名——粘进输入框时,字符层面是一段完全合法的文本,编码问题消失了,但那台设备的编号已经不再是现场标签上的编号,而导入环节不会给出任何提示。SlingGuard 只有这一条通道,TagWorks 两条都有。
六、首字符是语义:最小引用挡不住求值
RFC 4180 的引用规则保护的是分隔符与换行,不保护单元格的解释方式。OWASP 把这写成 CSV 注入(公式注入),触发字符清单是 =、+、-、@,外加制表符与回车,并注明部分区域设置下全角变体同样有效;这一模式的通用缺陷编号是 CWE-1236。
拿它对着第二节的三字符判定集看,交集只有一个回车。=1+1 不含逗号、不含引号、不含换行,于是原样写出,被表格软件读成 2;+86 138…、-20% 载荷折减、@route 3 这类在现场备注里完全正当的写法同样裸写。而当字段里同时含引号或逗号时,最小引用会生效——复算能同时给出这两种写出形态:'=1+1' 原样落地,'=HYPERLINK("http://…","…")' 被包成 "=HYPERLINK(""http://…"",""…"")"。包起来不改变结果:引号在解析阶段就被剥掉,单元格内容仍以等号开头,照样进入求值分支。
把两份清单叠在一起看更清楚:LF 在两边都出现,写侧会为它加引号,而引号在解析阶段就被剥掉,等于没有防护;CR 只在触发清单里出现,写侧既不为它加引号、自家解析器又把它当行尾,一个字符同时踩空了两处。
缓解方式本身是有代价的取舍。给每格前置单引号,或者在引号内前置制表符,都能挡住当前这一层:制表符方案会永久留在数据字节里,破坏第四节的往返;单引号方案更不稳,社区已复现过 "'=1+2" 经 Excel 保存再打开后被改写回 =1+1 并重新执行的过程,OWASP 也明确写着”没有对所有表格软件与所有下游都安全的通用策略”。对本项目的准确定位是两条:第一,端侧不执行任何东西,风险落在接收方的工作站上,属于交付物的下游属性,不能用”零网络”来覆盖;第二,若要缓解,前置单引号是不污染数据字符的选择,而且必须与导入侧成对实现——自家解析器读到首字符为单引号时剥掉它,否则这个缓解会先打断自己的往返闭环。
七、内置示例模板自己就是一次错位
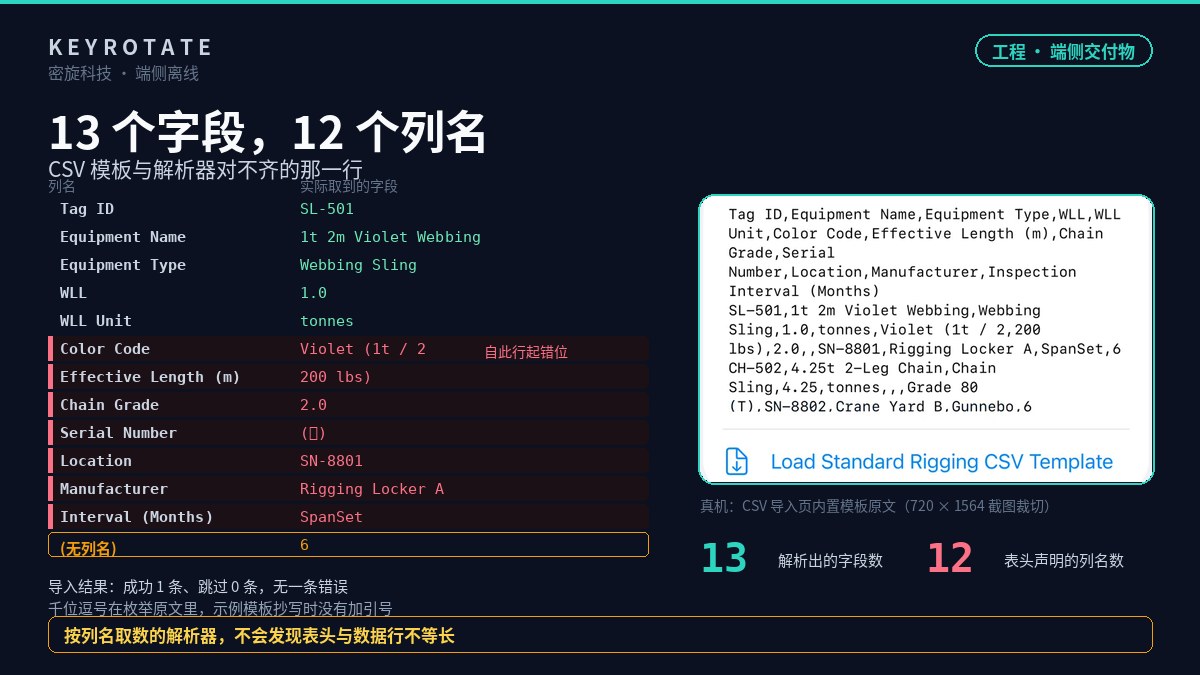
两款产品都在导入页提供一份示例文本。TagWorks 那份是六列、十个设备,字段里没有内嵌逗号,合法。SlingGuard 那份的第一条数据行长这样:
SL-501,1t 2m Violet Webbing,Webbing Sling,1.0,tonnes,Violet (1t / 2,200 lbs),2.0,,SN-8801,Rigging Locker A,SpanSet,6Violet (1t / 2,200 lbs) 里的那个千位逗号没有加引号——而这恰恰是第二节里说的那个由导出器一定会包起来的枚举值。手抄进模板之后,这一行被解析成 13 个字段,表头只有 12 列。错位从第 6 列开始,复算结果逐列如下:
| 列名 | 实际取到的值 |
|---|---|
| Color Code | Violet (1t / 2 |
| Effective Length (m) | 200 lbs) |
| Chain Grade | 2.0 |
| Serial Number | 空 |
| Location | SN-8801 |
| Manufacturer | Rigging Locker A |
| Inspection Interval (Months) | SpanSet |
| 无列名(多出的第 13 个) | 6 |
导入器不会为这件事报任何错:四个必填判据(编号、名称、类型、额定值)全在错位之前,颜色靠首词匹配仍然命中,长度那一格转不成数字于是留空,周期那一格拿到一个厂牌字符串、整数转换失败后被默认值 6 兜住,真正的 6 掉在列名之外被完整丢弃。界面上给出的结果是”成功导入 1 条”,没有跳过、没有错误,而序列号空着、位置写着别人的序列号、周期是猜的。
列数不匹配在两款解析里都没有闸门:取列的方式都是”按表头索引访问,越界即空串”,表头与数据行的长度差既不报错也不警告。内置模板的问题因此不是个例,而是同一处闸门缺失的一个必然产物——用户照抄它整理的存量表格,就会得到同样的错位。
(同类现象在字段映射层也出现过一次:TagWorks 导出的分类列写的是枚举原始值,而导入按带空格的英文短语匹配,导致回读时类别漂移。那条链另有专文展开,此处只作为”写方与读方的合同不同源”的第二个证据。)
八、26 列写出,6 列读回
导出与导入是两套代码、两份合同。
TagWorks 登记册导出 26 列,导入侧只解析 6 个列名:Asset、Identifier、Site、Class、Environment、Risk。其余 20 列——上次检验日、下次到期、状态、最近结论、记录类别、放行链、三项读数、检验员、仪器型号与序列号、校准日期、程序引用、备注、照片数、放行日期——回读时一个都不看。这本身是设计而非缺陷:导入的语义是接管设备清单,代码注释与导入页脚注都写着”要转移测试记录、证据与状态历史,请使用备份”。
SlingGuard 的资产册 19 列里,导入侧能对上列名的有 14 列,状态、下次到期、在案隔离记录号、关联放行日期与放行人这 5 列是只写不读的派生信息;检验证据表 31 列在导入侧零映射。
真正的问题在于这份合同没有写在文件里。表头之外没有任何一行说明:这是哪个版本的列集合、哪几列可回读、导出时间与时区是什么、哪些列是计算值。把测试历史表拿去导入会得到一句”缺少必需的 Asset 或 Name 列”,原因其实是列名对不上,而不是数据不存在;它的 AssetID 反倒会撞上标识别名列表里的一项。三份交付产物的合同强度可以并排比:
| 载体 | 自描述内容 | 读方约束 | 往返能力 |
|---|---|---|---|
| JSON 快照 | 版本号、包含性判据 | 仅本应用可解 | 完整(含证据与链) |
| PDF 报告 | 公司、资质、限制说明 | 只读,无回填 | 不设计往返 |
| CSV | 仅表头一行 | 由各家表格软件决定 | 6/26 与 14/19 |
九、可以收敛的动作
以下改动都能限定在导出与导入这几个函数内,不需要动存储格式。
| 优先级 | 动作 | 代价 |
|---|---|---|
| 高 | 转义判定集补上 CR,或统一以 CRLF 写行尾并把 CR 一并纳入包裹条件 | 一处条件判断,无外部依赖 |
| 高 | 写出加 UTF-8 BOM,并在 SlingGuard 表头归一时一并清掉 BOM | 需与 TagWorks 已有的剥 BOM 逻辑对齐成同一口径 |
| 高 | 导入前逐行校验列数与表头等长,不等即报错并列出行号,不再越界取空串 | 两个解析器各加一道闸门 |
| 中 | 固定格式日期显式设 POSIX locale、公历与明确时区,或统一改用 ISO 8601 格式器 | 字段口径变化,需要版本戳 |
| 中 | 读数列统一有效位与单位写法,并让导出层复用判定层的有限性检查 | 报告与 CSV 需同步改 |
| 中 | 首字符命中触发集时前置单引号,同时在解析侧对称剥除 | 不配对实现会破坏自家往返 |
| 低 | 内置示例模板改由导出器生成,禁止手写含逗号字段 | 构建期一次性改动 |
| 低 | 随 CSV 同表输出列清单(列名、类型、是否可回读、口径版本) | 交付物多一个小文件 |
十、边界
这份核查能说到的是:写出侧的判定集是哪三个字符、解析侧的行边界是哪三种写法、哪一列一定会被包裹、复算得到的错位表,以及 6/26、14/19 这两个真实的列合同比例。
这份核查说不到的是:某一台桌面软件在某个版本、某个区域设置下会把某个单元格显示成什么。Excel 会自动转换,Numbers 与 WPS 规则各不相同,Power Query 还能逐列指定类型;这些由接收方的软件决定,导出层无法声明式地控制。能控制的是字节,不是解释。
也正因为解释不可控,端侧工具更该把”文件自描述”当成工程目标:列合同、口径版本、导出时间与时区、哪些列可回读,由导出器写进文件本身,比在读方的默认行为上碰运气可靠。一份台账的可审计性,最后取决于那个被转发出去的文件里还留着多少上下文——而这一步,和采集时是否零遥测同样重要。
参考资料
- [1] RFC 4180:CSV 与 TSV 数据交换格式. rfc-editor
- [2] OWASP:CSV 注入(公式注入)与缓解权衡. OWASP
- [3] CWE-1236:CSV 特殊元素未中和. MITRE
- [4] Microsoft 365 Insider:可控制的自动数据转换. Tech Community
- [5] Apple QA1480:NSDateFormatter 与固定格式日期. Apple
- [6] Safe Work Australia: Managing electrical risks in the workplace(现场检验与记录义务). SWA
- [7] 英国 LOLER 1998 条例正文(检验记录与保留). legislation.gov.uk