
· engineering· 约 23 分钟精读
Qubitlab Offline Diploma Parent Report Readability Engineering — Technical Analysis | KeyRotate Technology
一台不联网的平板能给孩子开出一张什么形式的结业文书,又能给家长一份什么口径的进度说明?本文以密旋科技 QubitLab 的家长中心与证书模块为样本,逐字段普查三条产物链:报告页读进度、预览卡只读文案、导出文书连进度都不读;并列出同一个"探究总数"在文书正文、归档界面与源码常量里的三种取值,五枚没有任何调用点的文案键,以及深底满幅页面落到纸上时的物理代价。
一、一张要交到手上的文书
孩子完成一次探究之后,家长通常要做两件与屏幕无关的事:把这件事讲给别人听,以及找一件可以拿出去的东西。前者是口头的,后者是物证——贴到冰箱门上、发给祖父母、交给学校。一个不注册、不联网、没有服务端的端侧应用,能给出的物证只有两样:屏幕上的一张卡片,和一次导出。
密旋科技的 QubitLab 是一款面向应用商店的移动端量子物理与 STEM 启蒙沙盒:九十六关闯关玩法、可交互的布洛赫球面、双比特基础逻辑门拼装与概率测量演示,全程离线完成。本文不评价它的教学效果,也不讨论界面是否好看,只做一次静态普查,样本是它的家长中心与证书模块三个文件,以及整份本地化资源表。普查要回答的问题是:这三条产物链各自读到了什么数据,写出的句子又从哪里来。
二、三条产物链,三组入参
家长中心里真正会被”带走”的东西有三件,它们由三个不同的页面产出:
| 产物 | 入口 | 入参 | 形态 |
|---|---|---|---|
| 家长报告页 | 底部导航的家长中心标签页 | 本机进度对象 | 屏幕上的五个区块 |
| 屏幕预览卡 | 报告页摘要卡右上角按钮 | 姓名输入 + 文案键 | 一张固定高度的卡片 |
| 导出文书 | 预览页底部的导出按钮 | 姓名 + 语言 + 一次墙钟取值 | 一页 A4 横版 PDF |
第三条链的入参可以从源码里逐字读出,生成函数的签名是姓名、语言与日期三个参数,没有第四个参数。也就是说,进度对象根本没有进入导出这一级。这一点决定了后面许多看起来像文案问题的现象,其实都源自一次结构性的取舍。
三、屏幕所见与手上所得
先看最容易被忽略的一处差异。屏幕上的预览卡与导出的 PDF 并不是同一次排版的两种分辨率,而是两次彼此独立的排版,字段集合本身就不一样。
| 行 | 屏幕预览卡 | 导出文书 |
|---|---|---|
| 机构抬头 | 有 | 有 |
| 副标题 | 无 | 有 |
| 授予语 | 有 | 有 |
| 表彰正文 | 有 | 有 |
| 凭证编号 | 有 | 有 |
| 徽章行 | 无 | 有 |
| 日期行 | 无 | 有 |
预览卡有五行文案,导出的文书有七处文字绘制。差出来的两行是徽章与日期,而这两行恰好是纸质文书上最能体现”正式感”的部分:屏幕上看不到日期,纸上才有。反过来,预览卡把机构抬头与授予语放在同一张深色卡里并由界面控制字距,导出件则用固定点值重新排一遍——两处的观感接近,但没有任何共享的排版计算在维持这种接近。
由此得到第一条结论:屏幕所见不等于手上所得,而且差异不是缩放造成的,是字段清单造成的。一个只在屏幕上确认过效果就点导出的用户,拿到的是一份他从未完整看过的文件。
四、文书与进度解耦
第二条链读进度,第三条链不读。把两个环节并排放,差别相当直观:
| 环节 | 读到的数据 | 输出 |
|---|---|---|
| 家长报告页 | 逐关星数字典、已完成实验集合、每项测验得分 | 星数总和、达标判定、六行检查清单 |
| 屏幕预览卡 | 姓名输入框内容 | 授予语与表彰正文 |
| 导出文书 | 姓名、当前界面语言、一次墙钟取值 | 正文、日期、徽章与编号 |
报告页那一侧是诚实的:六行检查清单的勾选来自”已完成实验集合”,右侧的测验成绩来自每项测验的得分记录,两者都是本机真实数据,屏幕上确实有证据可看。
文书那一侧则不同。它的正文是一句固定文案,句式是”为完成全部探究而授予”,与进度无关。这意味着,一台从未打开过任何关卡的设备,与一台全部通关的设备,导出的文书在正文、编号与徽章上可以完全相同。这是静态普查能给出的最强的一条结论,也是最需要克制表述的一条:它不构成任何安全指控,也不说明实现有错——这类文书被设计成纪念物,而不是能力证明。只是当一份产物被命名为”荣誉证书”时,名称与它所绑定的数据量之间的落差,应当被写下来。
五、凭证编号是一个编译期常量
编号那一行值得单独看。它在八种语言的资源表里都有译文,但被翻译的只有冒号之前的标签,冒号之后的编号本体逐字相同。
| 语言 | 标签 | 编号 |
|---|---|---|
| 简体中文 | 防伪凭证编号 | QL-VERIFIED-OFFLINE |
| 英文 | CREDENTIAL ID | QL-VERIFIED-OFFLINE |
| 日文 | 認定ID | QL-VERIFIED-OFFLINE |
| 德文 | ZERTIFIKAT-ID | QL-VERIFIED-OFFLINE |
中文标签里写着”防伪”。把这个词的实现面写出来:编号是一个编译期字符串常量,在同一版本的全部设备、全部用户之间完全相同,不含逐份信息,没有校验位,也没有签名。若把”同一版本内所有可知编号的取值个数”记作编号空间的大小,则
一个大小为 1 的编号空间不提供任何可核验的逐份属性。这不等于”防伪”这个词一定站不住:文书本身是深色页面上的装饰性文字,它的用途是让页面看起来完整,而不是承担验证职责。真正的工程风险在于措辞依赖:当文案承诺了一个属性,实现却没有对应的数据时,日后任何一次复制或改写都会把落差放大。稳妥的做法有两个方向,任选其一:要么让编号由本机数据派生(例如姓名与完成时刻的摘要截断),要么把标签改成与实现相符的说法。
六、同一个数字的三种取值
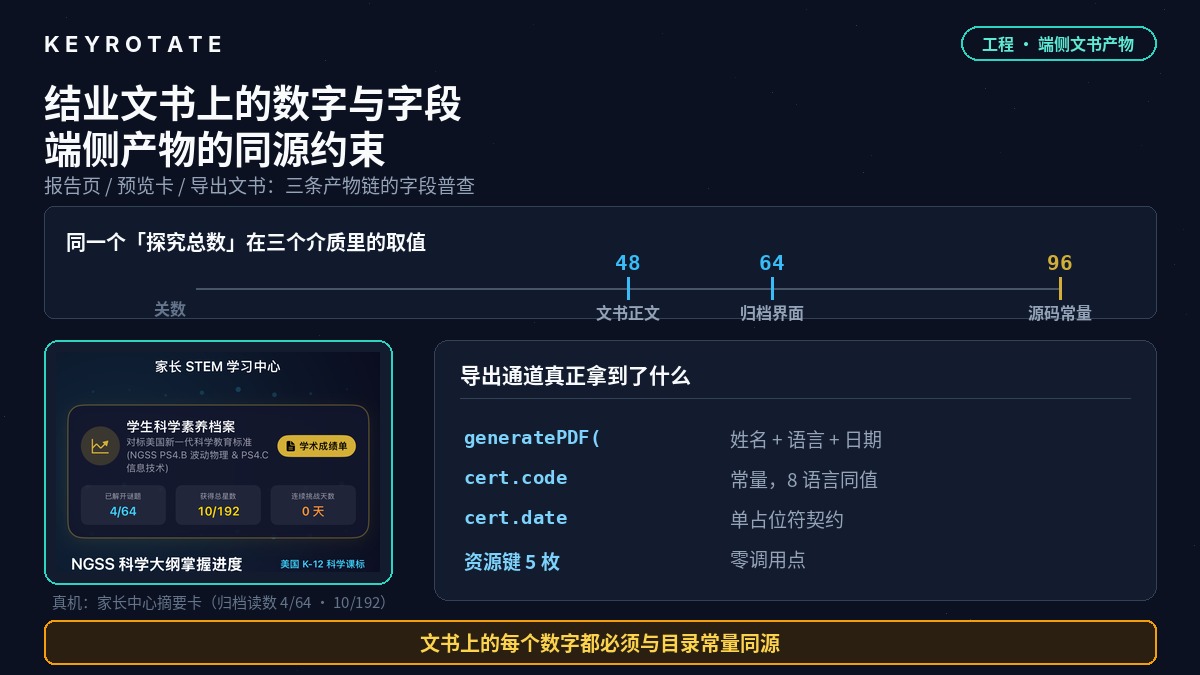
“探究总数”这个概念在产品里至少留下过三个不同的数字,而且它们分别躺在三种不同的介质里:
| 出处 | 介质 | 取值 |
|---|---|---|
| 文书表彰正文(简体与繁体) | 本地化字符串 | 48 项 |
| 家长中心的归档界面截图 | 图片像素 | 4/64 与 10/192 |
| 当前源码的课程目录常量 | 代码常量 | 96 关,星数上限 288 |
三行数字的读法要分开。第二行是仓库里归档的一张家长中心截图:摘要卡的三个读数分别是已解开谜题 4/64、获得总星数 10/192、连续挑战天数 0 天,星数上限等于关数的三倍,内部是自洽的。第三行是当前源码里的目录常量,关数九十六,星数上限为
第一行则写在表彰正文的字符串里:“以表彰其在 48 项严谨探究中……”。其余六种语言的同一段正文都不含数字,只有中文本地化把 48 写死进了句子里。
把这三种介质放在一起,工程上的判断是明确的:凡是能在运行时由常量算出的数字,就不要写进文案字符串。字符串里的数字不会随常量变化,它把某一版本的事实冻结在了翻译资源里;而翻译资源的评审通常只看语言,不看数值。这类数字的漂移不会引发崩溃,只会让同一个产品在不同介质上说出不同的数。可行的约束是把数值改成运行时插值,并在资源评审清单里加一条:文案中不得出现与版本相关的数字。
七、字段级覆盖不齐的一张卡片
家长报告页里有一组按课程标准逐条列出的卡片,每条卡片的数据来自一个结构化条目,它有四个需要显示文本的字段,每个字段各自带着自己的语言分支。把覆盖情况逐个查出来,得到这样一张表。
| 字段 | 覆盖语言 | 语言数 |
|---|---|---|
| 标准名称 | 简体中文、繁体中文 | 2 |
| 学段说明 | 简体中文、繁体中文 | 2 |
| 描述正文 | 简体中文、繁体中文 | 2 |
| 关联实验名 | 简体、繁体、日文、韩文 | 4 |
这四处分支写在结构化条目的计算属性里,与整站资源表是两套独立机制。它们生效不生效,只取决于条目编号是否命中了那一串分支,没有任何默认值检查把它们串起来。
后果落在具体的一张卡片上:使用日文的家长,会看到日文的关联实验名,同时读到英文的标准名称、学段与描述;使用西班牙文、法文或德文的家长,整张卡片都是英文,而卡片外那一行区块标题是本地语言。这不是”没翻译”,而是同一张卡片的一半被翻译了。对一份要交给家长的读物而言,混排的两种语言比整页英文更难读——读者的语言切换成本从”一次性适应”变成了”逐行判定”。
八、五枚没有调用点的文案键
把整份资源表里所有以家长与证书为前缀的键挑出来,共四十四枚,再逐枚回查全部 Swift 源文件中的调用点。结果有五枚键值得一提:它们在八种语言里都写好了译文,却在工程里一次也没有被引用。
| 键 | 英文取值 | 原本应有的落点 |
|---|---|---|
| cert.enterName | Student Full Name | 姓名输入框的占位提示(实际用的是 cert.defaultName) |
| cert.share | Print / Share High-Res PDF | 导出按钮的第二文案(实际用的是 cert.export) |
| parent.viewCert | View Honors Diploma | 打开证书的按钮文案(实际用的是 parent.transcript) |
| parent.teacherEndorsement | Recommended for K-12 STEM Classrooms & Science Fairs | 报告页的推荐语区块 |
| parent.unlockPrice | One-Time Purchase: %@ 与家庭共享提示 | 升级横幅里的价格行 |
第三行带出另一处措辞漂移:报告页右上角的按钮文案是”学术成绩单”,点开之后落在一个标题为”少年量子物理学家荣誉证书”的页面上。同一件事在入口与产物上用了两个名字。
死键的代价常常被低估。按行计费的翻译交付会为每枚死键付出八行;更麻烦的是维护面——后来的维护者看到资源表里有”查看荣誉证书”这行译文,很容易推断这个功能已经实现。静态引用计数也有它的能力边界:它只能说明”在 Swift 源码里没有被引用”,不能排除由自动化走查、外部工具或字符串拼接间接取到;不过在这个工程里,走查脚本取的是可访问性标识而不是文案,所以按字面统计的结论在这一侧是可靠的。
九、格式串契约与盒子高度
日期那一行是一个典型的格式串契约。它的模板在八种语言里都是”某个前缀加一个百分号占位符”,例如英文是 Date 加一个参数位,德文是 Datum 加一个参数位。
| 语言 | 模板 | 占位符个数 |
|---|---|---|
| 英文 | Date: %@ | 1 |
| 简体中文 | 日期: %@ | 1 |
| 法文 | Date : %@ | 1 |
| 韩文 | 발급일: %@ | 1 |
八种语言各恰好一个占位符,现状是干净的。要留意的是这类契约没有任何编译期校验:占位符数与参数个数不匹配时不会报错。少一个,日期就静默消失,页面上只剩”日期:“两个词;多一个,则会去读栈上并不存在的参数。因此把占位符个数写成自动化断言,是这一层唯一可靠的守卫。
第二个与语言相关的量是高度。文书正文被放进一个固定高度的矩形里,文字按绘制矩形裁切,溢出时不会有任何提示。而同一段正文在不同语言里的长度差别很大:
| 语言 | 正文字符数 | 相对英文 |
|---|---|---|
| 德文 | 165 | 1.21 |
| 法文 | 160 | 1.18 |
| 西班牙文 | 157 | 1.15 |
| 英文 | 136 | 1.00 |
| 韩文 | 72 | 0.53 |
| 日文 | 58 | 0.43 |
| 简体中文 | 57 | 0.42 |
长短相差接近三倍。固定盒高必须按最长的那一种语言留余量,而不是按母版语言的观感定高,也就是要求
其中 是语言 在给定字号与行宽下所需的实际高度。这条不变式写起来只有一行,却决定了排版资源评审时应当拿哪一种语言的截图去比对——答案是最长的那一种,而不是最好看的那一种。
十、纸张化边界
导出件的页面是 A4 横版,宽高为 842 与 595 点。整页先铺一层深色底,再叠内外两层描边,文字用浅色绘制。这套配色在屏幕上与应用的深色外观是一体的,落到纸上却是另一次取舍。
第一层代价是耗材与对比度。满幅实色覆盖会按整页面积消耗墨粉;彩色喷墨转黑白之后,浅色文字与深色底之间的明度差会随设备驱动的灰度映射而收窄,低端打印机上字形边缘容易糊。屏幕上”文字压在深底上”是一种风格选择,纸上它是黑白翻转的负担。
第二层代价要分两个概念说,不能混为一谈。这些绘制写出的是真实的文本对象,字体随文档嵌入,因此文书上的姓名与日期可以被选中、被复制、被检索,这一点是成立的。但页面没有结构标签,没有内容语言标注,也没有文档标题与作者这类元数据,因此读屏软件与全文索引拿到的是一个没有骨架的平面。文本层可用与结构层缺失并存,是两个独立的结论。
第三层代价落在交付通道上。文书生成之后以裸字节数据交给系统分享面板,不带文件名,也不带类型提示。它落进文件管理器、邮件附件或打印队列时,命名由接收方决定;使用者拿到的可能是系统按时间生成的默认名称。这是把”最后一次命名”的机会交出去的做法,代价不大,但确实少了一次。
需要一并说清的是格式合规的边界。面向归档的一致性级别(例如以外观长期可重现为目标的 PDF 一致性约束)保证的是页面能按原样重现,不保证页面上的陈述为真。对这份文书而言,它原本也不是凭证,所以这一层边界不会带来额外风险——被写在该说清楚的地方就好。
十一、结语:四条可以落地的工程线
把上面的普查收成四条可执行的线:
第一,产物同构。屏幕预览与导出文书共用同一份字段清单与同一次排版计算;如果出于版面原因必须分叉,就在预览卡上显式标出导出件另含日期与徽章,让用户在导出前知道手上会多两行。
第二,数字同源。文书里任何可由常量算出的数字一律改为运行时插值,字符串资源中不出现与版本相关的数值,并把这一条写进翻译资源评审清单。同一条规则适用于星数上限这类派生量。
第三,键位回收。上线前对全部资源键做一次调用点普查,死键要么删除要么补上落点;把这项检查做成脚本而不是人工核对,因为它恰好是人工最容易漏掉的一类。
第四,最长语言定高与占位符断言。固定盒高按最长语言留余量,格式串占位符个数写进自动化断言,两项都不依赖人的眼力。
最后是这份普查没有覆盖的东西。静态审计能说明工程里有什么、缺什么,说明不了用户体验;一份文书能不能证明孩子学到了什么,取决于它绑定了多少本机数据,而不取决于页面做得多像一份证书。端侧离线产品的隐私承诺来自”数据不出设备”,而这类文书的可用性来自另一个方向的问题:哪些数据被带上了纸面。这两个方向并不冲突,它们只是各自需要有人负责。
参考文献
[1] Apple Inc. UIGraphicsPDFRenderer. https://developer.apple.com/documentation/uikit/uigraphicspdfrenderer [2] Apple Inc. UIActivityViewController. https://developer.apple.com/documentation/uikit/uiactivityviewcontroller [3] Apple Inc. Human Interface Guidelines: Typography. https://developer.apple.com/design/human-interface-guidelines/typography [4] Apple Inc. String format specification. https://developer.apple.com/documentation/foundation/stringformat [5] NGSS Lead States. HS-PS4-3: Wave-Particle Duality of Light. https://www.nextgenscience.org/pe/hs-ps4-3-waves-and-their-applications-technologies-for-information-transfer [6] PDF Association. PDF/A in a Nutshell. https://pdfa.org/resource/pdfa-in-a-nutshell/