
· engineering· 约 25 分钟精读
Bulk Intake of Legacy Register Spreadsheets: RFC 4180 Parsing, Identifier Identity Keys and Auditable On-Device Migration
A close engineering walk-through of how KeyRotate TagWorks takes over an existing electrical-equipment register from a spreadsheet: character-level RFC 4180 parsing (quoting, embedded commas and newlines, UTF-8 BOM), header-alias normalisation, idempotent identifier canonicalisation with non-destructive conflict suffixing, permissive-but-visible fallbacks for unparsed enumeration columns, whole-file validation before a single atomic write, and the round-trip contract between the register-summary CSV and the UTC event-history CSV — all completed offline with no server-side step.
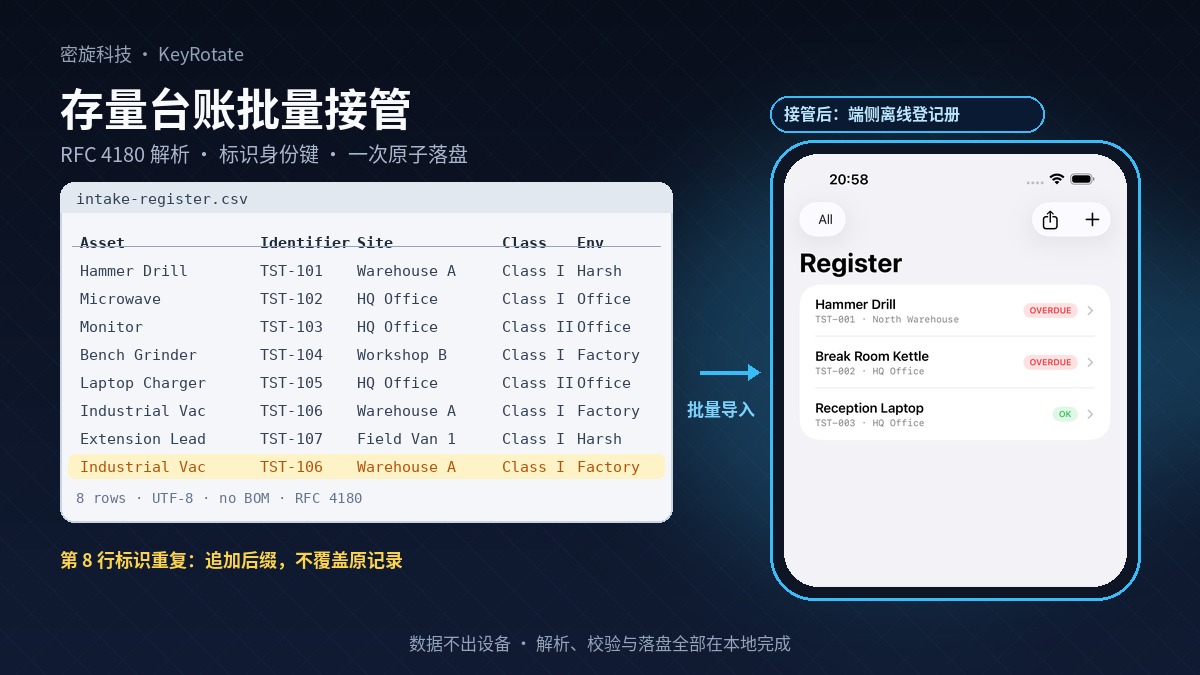
一、“数据不出域”的第一道关口在导入
2026年9月下旬,中国电信在2026中国—东盟人工智能部长圆桌会上发布金融人工智能服务共享成果,对外表述仍是那句话:数据不出域、模型可共享[9]。这个提法在行业里已经讲了好几年,但落到一台离线的手机或平板上,它的第一道关口往往不是检测、不是报告,而是把手头那本存量台账搬进设备的那一刻。
理由很实际。一支电气维保班组的登记册动辄几百台设备:车间里的手持电动工具、库房里的延长线盘、临时用电的焊机、办公区的显示器与充电器。要求作业人员逐台手工录入,等于把迁移成本全部压到最枯燥、也最容易出错的环节上——人手工输入一百台设备的设备等级、使用环境与风险等级,出错率不会低,而且出错时不会有任何提示。因此批量接管不是可有可无的附加功能,它是台账能不能真正落地的前提。
端侧工具在这件事上没有退路。它没有服务端的数据处理阶段可以补救,也不会在服务器上留下一份可供追溯的导入日志。文件由使用者从系统的文件应用里主动选择,解析、校验、身份去重、落盘全部在同一台设备上发生,“数据不出设备”在这里是字面意义上的:输入文件与登记册都在本地,整条链路没有任何一段离开硬件。这在隐私上是对的,在工程上则意味着所有质量保证都必须前置,而且必须可见。
下面以密旋科技 TagWorks 离线登记册的批量接管实现为样本,把这件事拆成三条线:字节层的解析正确、身份层的键与冲突、边界层的默认与可见性,最后回到迁移本身的可审计性。同一套语义在 SlingGuard 的索具登记册上同样成立,只是列词表换成了现场用语[6][7]。
二、字节层:CSV 不是”按逗号切开”
(一)真实表格会打破直觉
RFC 4180 定义的 CSV 不是一种”逗号分隔的文本”,而是一种带引号转义的记录格式[1]。现场台账来自各种来源:固定资产系统导出的表、安全员在表格软件里手工整理并另存的表、上级单位下发的统一模板。它们共同的属性是不规整,而其中相对规整的一条是:凡是单元格里出现逗号、双引号或换行的内容,都会被一对双引号包起来,内部的引号用两个引号表示。
于是最直觉的实现——先按换行切开、再按逗号切开——会在这些位置整段错位。错位的后果不是程序崩溃,而是更难发现的静默错位:某一行的场所字段吞掉了下一列的内容,设备被归到错误的使用环境,进而落到错误的复检间隔上,而界面上一切正常。
| 源文件片段 | RFC 4180 的正确结果 | 按逗号直切的结果 |
|---|---|---|
| 引号包裹的 “Crosby, 4.25 t” | 一个字段,逗号属于字段内容 | 切出两个字段,后半截错位 |
| 含内嵌引号的 12"" 弓形卸扣 | 一个字段,还原为一个引号 | 引号残留,字段被截断 |
| 引号内包含换行的备注 | 仍是一条记录,字段内含换行 | 被误判为两条记录 |
| 文件以 UTF-8 字节序标记开头 | 首个列名不含不可见字符 | 首列列名匹配失败 |
| 换行符 CRLF 与 LF 混用 | 记录边界一致 | 行尾残留回车符 |
(二)用字符级状态机而不是正则
正确做法是把整个文件当作一个字符流,用一个”是否在引号内”的状态位驱动扫描:引号外遇到开引号进入引号态;引号态内遇到成对引号视为转义、写出一个引号;引号态内遇到单独引号退出引号态;引号态之外遇到逗号才切分字段;遇到换行(无论 LF 还是 CRLF)才切分记录。TagWorks 的导入器正是按字符逐步推进的[6],并在扫描之前先剥掉 UTF-8 字节序标记,避免首个列名带上一段不可见字节而匹配不上[2]。
这条规则有一个直接推论:字段数与记录数都不能在扫描之前确定。用换行符计数得到的”行数”,在含引号换行的文件上必然偏大,而偏大的行数会误导使用者以为有大量坏行。正确计数只能来自状态机扫描结束后的产物:
其中 是状态机在引号态之外识别到的记录终止符个数, 是扫描结束时的残余缓冲区:非空则说明最后一行没有以换行结尾,但它仍是一条完整记录。同一个状态机顺带产出每行的字段数组,作为下一层校验的输入。
三、列的语义还原:表头别名与归一
(一)表头是人的语言,字段是程序的语言
得到二维数组之后,第二件事是决定”第几列是什么”。同一份台账里,设备名可能被写成资产、名称、设备、物品、名称描述;编号可能被写成标识、标签、条码、序列号、资产编号。要求使用者在导出前把表头改成本工具的口径,是把成本转嫁给现场;而更糟的做法是用模糊匹配去猜,因为语义相近的表头经常指向不同的东西,比如位置与所属单位、编号与序列号。
TagWorks 的做法是一张显式的同义词白名单:对表头做去空格、转小写之后逐项命中,取第一个匹配成功的列作为绑定列[6]。
| 目标字段 | 接受的表头写法(归一化后) | 绑定规则 |
|---|---|---|
| 设备名称 | asset、name、description、item、title、appliance | 必填,缺失即整份拒绝 |
| 标识符 | identifier、tag、barcode、serial、id、assetid、tagid | 可缺,缺失时自动生成 |
| 场所 | site、location、building、room、area、facility | 可缺,缺省为空串 |
| 设备等级 | class、applianceclass、type | 可缺,未识别按默认档 |
| 使用环境 | environment、env | 可缺,未识别按默认档 |
| 风险等级 | risk、risklevel | 可缺,未识别按默认档 |
SlingGuard 的索具登记册沿用同一思路,词表换成现场用语:标签号、设备名称、设备类型、额定工作载荷、载荷单位、颜色代码、有效长度、链环等级、序列号、位置、制造商、检测间隔(月)[7]。两处实现共享的判据是同一条:不猜语义,只认白名单;无法识别就退回默认,并且把”退回了默认”这件事说出来。
(二)多余的列不是错误
使用者的表里往往还有采购日期、责任人、资产原值、存放柜号等本工具并不承载的列。这些列一律忽略,既不报错,也不进入登记册。这条规则让迁移可以直接吃下”从财务或固定资产系统整表导出”的文件:使用者不需要为了导入而删列,只需要保证必填列存在。
四、身份键:标识符是台账的主键
(一)规范化必须是幂等的
登记册里真正的主键不是设备名称,而是标识符:它是设备上贴的标签、是现场扫描的入口、也是历次检测记录挂靠的锚点。前面的记录链讨论已经说明,本工具生成的复合标签串形如”工具前缀加若干分隔字段”,其中携带设备编号;识别时应把复合串解析回编号本身,而普通编号必须原样保留[6]。这个规范化函数是幂等的——对同一串重复调用结果不变,对非本工具格式的编号不做任何改写。登记册按标识查找时也会对两侧同时规范化,因此无论库里存的是纯编号还是整条标签串,扫描都能命中,存储形态不构成正确性风险。
(二)冲突要加后缀,绝不静默覆盖
批量导入最容易犯的错,是用新数据覆盖旧记录。设想一位安全员把同一份电子表格导了两遍:第二遍导入时,所有标识都已存在。若实现是”按标识覆盖”,那么第一遍导入之后在现场补录的检测记录就会被悄悄抹掉。TagWorks 的选择是:标识冲突时不覆盖,而是给新条目追加数字后缀,直到在已见标识集合中找不到为止;同时每一条冲突都会在警告清单里点名,并附上源文件行号[6]。
其中 表示字符串拼接, 是库内已有标识与本次已产出标识的并集。这样处理之后,重复导入不会被误当成”无操作”,而是留下可见的痕迹:库里多了几台以 -2 结尾的设备,等待人工判定。索具登记册在这一点上采取的是另一种同样不静默覆盖的策略——重复标签号按行报错并跳过该行,由使用者决定改名还是放弃[7]。
(三)缺标识的代价要写在明处
没有标识的设备不该进登记册,因为它之后无法被扫描、也无法被单独追溯。这类行的处理是自动生成形如 IMP-0001 的临时编号,并在警告中标注。代价是真实的:生成的编号在设备实体上并不存在对应的标签,必须由现场补打标签、贴到设备上,才算完成闭环。工具能做的是把这件事明确说出来,而不是让使用者以为导入完成就大功告成。
| 情形 | 处理 | 现场需要跟进的动作 |
|---|---|---|
| 标识与库内已有重复 | 追加后缀,保留原记录 | 判定是新设备还是重复导入 |
| 标识列缺失或为空 | 生成临时编号 | 为设备补打标签并贴附 |
| 标识为工具复合标签串 | 规范化回编号 | 无 |
| 表头整体没有标识列 | 全部行按上一条生成 | 全量补打标签 |
(四)两条写入路径的分工
单条新增与批量接管是两条不同的写入路径。单条新增在写入前会做一次”规范化后是否已存在”的判定,命中就拒绝并提示;批量接管则由导入器在解析阶段统一完成冲突解析,落盘时整批追加[6]。这个分工是有意为之:冲突判定必须在预览阶段完成,使用者才有机会在写入之前看到”第 37 行标识重复,将改为某某后缀”这样的提示。把去重推到写入时才做,等于把决策过程藏起来。
五、边界层:默认值必须可见
(一)未解析字段的兜底取值
电子表格里的枚举写法五花八门。设备等级一列可能写一类的罗马数字、也可能写”双绝缘""二类”;使用环境可能写”工地""车间""长期轻负荷""办公室”。导入器用关键字包含判定来还原它们,能识别的就识别,识别不了的一律退到默认档[6]。
| 字段 | 兜底默认 | 在复检间隔表里的方向 |
|---|---|---|
| 设备等级 | 双绝缘 | 相对宽松 |
| 使用环境 | 办公等良好环境 | 相对宽松 |
| 风险等级 | 低风险 | 相对宽松 |
(二)宽松兜底与现场复核的张力
这三个默认在方向上都偏宽松:双绝缘等级不需要保护接地连续性测量,办公环境与低风险对应的是更长的复检间隔。宽松兜底的好处是”不因一个没写清的单元格而丢掉整行设备”——设备进了册,就有机会在首次检测时被纠正;代价是必须把补全显式暴露,否则一台本该按工地环境三个月复检的手持工具,会被静默地排到一年之后。
因此实现上有三条硬要求。第一,未识别字段的补全逐行进入警告清单,而不是只留一条汇总。第二,校验摘要里把”警告条数”与”就绪台数”两个数字并列,让使用者一眼判断这次导入的质量。第三,预览展示的是落盘后的真实形态——等级、环境、风险都以最终值呈现,使补全结果在写入之前就可见。
一条更严格的路径是:在数据模型里把”显式给出”与”兜底补全”区分开,让到期计算对补全过的设备取更保守的档位,并由使用者逐台确认后才转为显式值。这是可选的加固方向,但它仍然服从同一个原则——默认可以宽松,默认不允许隐藏。
六、事务性:整份先校验,一次才落盘
(一)失败面与行为
端侧登记册的每次写入都是对本地文件的原子替换[3],批量接管沿用同一条纪律:整份文件解析、逐行校验、身份解析、摘要统计全部在内存中完成,只有使用者确认提交的那一刻才写盘。任何一个环节失败,登记册都保持原样。
| 失败面 | 行为 | 使用者看到的信息 |
|---|---|---|
| 文件为空或只有表头 | 不解析,不写入 | 明确的空文件或缺少数据行提示 |
| 缺少名称列 | 整份拒绝 | 缺失的列名 |
| 单行名称为空或字段数不足 | 跳过该行,其余继续 | 带源文件行号的警告 |
| 落盘失败 | 登记册不变更 | 保留应用、释放空间后重试 |
| 批量后超出免费额度 | 不写入,转入升级入口 | 当前台数与额度上限 |
(二)行号要与源文件对齐
所有警告都带源文件行号,且表头计为第 1 行——与使用者在表格软件里看到的行号一致。这一条看似琐碎,实际决定迁移能不能收敛:安全员拿着警告清单回到原始表格,按行号逐条修正、重新导出、重新导入,几轮之后警告清零。若行号与源文件错位,用户就只能逐行比对,迁移往往就停在半途。
七、出口:两条 CSV 与一份回导契约
迁移不是单向的。端侧工具需要两种导出,用途不同,格式约束也不同[6]。
| 出口 | 内容 | 关键约束 |
|---|---|---|
| 入册概要 CSV | 资产身份与分类、最近检测日、到期日、当前状态、证据状态 | 与导入列同名同序,可原样回导 |
| 事件历史 CSV | 逐条的检测、维修、复测与放行事件 | 时刻用 UTC、含毫秒的小数位,按标识、日期、记录编号三级定序 |
入册概要之所以要把列口径与导入器对齐,是为了让”导出、在表格里批量修正、重新导入”成为可行的运维手段。这条路径在迁移前后恰好最被需要:把一份旧台账接管进来之后,往往紧接着就要修正一批场所名称或分类错误,直接在表格里改比在应用里逐台改快得多。事件历史承担的是另一件事——一次可交接的证据转出。为保证可比对,它使用统一的时刻格式与三级定序,同一份数据重复导出得到字节层面一致的结果,可以直接做文本比对,而不必先信任某个专属解析器[10]。
这里有一条边界必须讲清楚:照片证据与检测记录之间的引用关系不进 CSV。原因不是实现偷懒,而是引用完整性——照片与记录之间是多对多的引用闭包,把它塞进单元格意味着在纯文本里重建一层引用关系,任何一次手工编辑都可能把它切断。因此全保真迁移由自包含备份档案承担,CSV 只负责身份与分类这一层。两条通道的分工必须在产品里说明白,否则使用者会以为”导出了 CSV 就等于备份了全部证据”[8]。
把前几节合起来,一次可审计的迁移应当留下四样东西:导入前的入册概要导出(回滚基线)、导入时的校验摘要与警告清单(决策记录)、导入后的差异比对(台数、标识集合、状态分布)、以及首次检测前对补全字段与临时标识的复核。前两样由流程本身产出,后两样需要按流程执行。工具无法替代后者,但它至少能让每一步都留下可比对的文本。
八、结语
批量接管发生在每本台账生命周期的开头,却决定了此后每一次到期判定、每一份报告、每一次审阅的准确性。端侧工具在这里没有服务端补偿,于是质量问题只能在设备内闭环解决:字节层要按状态机解析而不是按逗号切分,列语义要认白名单而不是靠猜测,标识符要做幂等规范化、对冲突加后缀而不是覆盖,未解析字段可以宽松兜底但必须逐行可见,写入要么整份通过、要么完全不发生。
这些约束没有一条依赖网络。它们依赖的是同一种态度:把工具做不到的事情讲清楚,把工具做过的事情留下来。
参考文献与标准
[1] IETF. RFC 4180: Common Format and MIME Type for Comma-Separated Values (CSV) Files. https://www.rfc-editor.org/rfc/rfc4180.txt [2] IETF. RFC 3629: UTF-8, a transformation format of ISO 10646. https://www.rfc-editor.org/rfc/rfc3629 [3] Apple Inc. Data.write(to:options:) 原子写入语义. https://developer.apple.com/documentation/foundation/data/write(to:options:) [4] Standards Australia / Standards New Zealand. AS/NZS 3760:2022 In-service safety inspection and testing of electrical equipment. https://www.standards.org.au/standards-catalogue/sa-snz/electrotechnology/el-036/as-slash-nzs—3760-colon-2022 [5] UK Health and Safety Executive. Lifting Operations and Lifting Equipment Regulations 1998 (LOLER). https://www.hse.gov.uk/work-equipment-machinery/loler.htm [6] 密旋科技. TagWorks 端侧登记册批量导入与导出实现:RFC 4180 分词、表头别名解析、标识冲突后缀与批次原子写入. 工程代码位于 /root/14TB/apps/tagworks/Sources/TagWorks/Services/. [7] 密旋科技. SlingGuard 索具登记册 CSV 导入与导出实现:标签号、额定工作载荷与检测间隔列映射. 工程代码位于 /root/14TB/apps/slingguard/Sources/SlingGuard/Services/. [8] 密旋科技. 端侧离线登记的备份与恢复完整性工程:自包含证据档案、恢复前校验与预恢复安全点的确定性回滚. https://www.keyrotate.com/blog/offline-register-backup-restore-transaction-integrity/ [9] 搜狐网. 中国电信在2026中国—东盟人工智能部长圆桌会上发布金融AI服务共享量子安全创新成果. 2026-09-28. https://m.sohu.com/a/1081796616_482239 [10] IETF. RFC 3339: Date and Time on the Internet: Timestamps. https://www.rfc-editor.org/rfc/rfc3339